
Компанія DeepSeek випустила оновлення V4.1-Flash-1017, яке офіційно описує як «мінорне», проте з помітним приростом у програмуванні та агентних задачах. Разом із моделлю китайський стартап відкрив доступ до власної пошукової системи: Search API та Fetch API тепер може підключити будь-який розробник.
Що відомо про модель
Попередня V4.1-Flash вийшла 10 вересня. Оновлення з індексом 1017 доступне на сайті DeepSeek, у застосунку та через API під тією самою назвою deepseek-flash. Ціни не змінилися. Ваги опублікували на Hugging Face за ліцензією MIT.
За даними The Decoder, модель швидше завершує завдання та генерує коротші відповіді, ніж попередниця. Її налаштували під середовища DeepSeek Harness, Tencent CodeBuddy і WorkBuddy. Для DeepSeek Harness компанія радить версію 0.2.1-rc.1 або новішу.
Навчання на власних оцінках
Для створення проєктів «з нуля» DeepSeek застосувала навчання з підкріпленням на самозворотному звʼязку (RLSF). Модель використовує власні внутрішні оцінки впевненості або згенеровані нею самою зауваження як сигнал винагороди. Через це не потрібні ні люди-оцінювачі, ні окремі моделі винагороди.
Як приклади компанія показала 3D-модель Забороненого міста, браузерну гоночну гру та відтворення Portal 2 на рушії Godot. У DeepSeek називають такий підхід «програмуванням за бажанням»: користувач описує бажаний результат словами, а ШІ-агент проходить увесь цикл розробки.
Цифри: не абсолютний лідер, зате з дуже вигідним співвідношенням ціни й якості
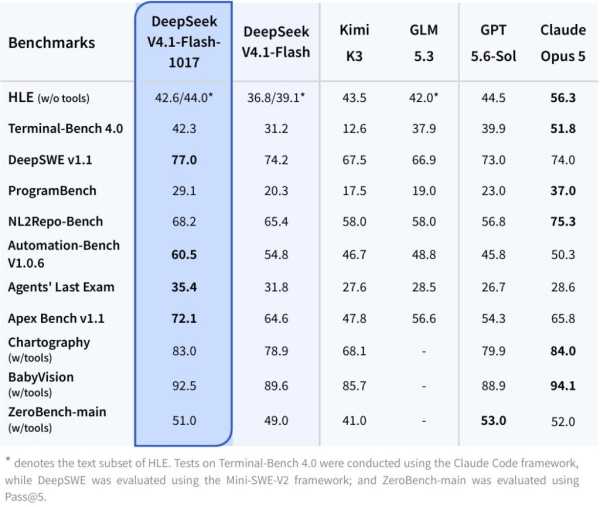
Найгучніше досягнення — 77,0% у тесті DeepSWE v1.1, тоді як Claude Opus 5 має 74,0%, GPT-5.6 Sol — 73,0%, Kimi K3 — 67,5%, GLM-5.3 — 66,9%. Але таблиця на сторінці моделі показує, що перемога не тотальна:
| Тест | V4.1-Flash-1017 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 77,0 | 74,0 | 73,0 |
| Automation-Bench v1.0.6 | 60,5 | 50,3 | 45,8 |
| Agents’ Last Exam | 35,4 | 28,6 | 26,7 |
| Terminal-Bench 4.0 | 42,3 | 51,8 | 39,9 |
| ProgramBench | 29,1 | 37,0 | 23,0 |
| NL2Repo-Bench | 68,2 | 75,3 | 56,8 |
| HLE (без інструментів) | 42,6 | 56,3 | 44,5 |
Із 11 тестів, які навела DeepSeek, Opus 5 випереджає її модель у сім, а GPT-5.6 Sol — у два. Виграє DeepSeek переважно в агентних сценаріях.
Головний козир — вартість. За графіком DeepSeek, у DeepSWE модель дає 77,0% при середній ціні трохи нижче $0,20 за завдання. В економному режимі вона набирає понад 72% приблизно за $0,10. Попередня версія мала 74,2%, але коштувала близько $0,50. Для порівняння, GPT-6 Astra, Gemini 3.8 Flash і Claude Opus 5 на цьому графіку обходяться від $2 до понад $10 за завдання.
Усі порівняння зроблено самою компанією. Незалежної перевірки поки немає.
Пошук DeepSeek тепер доступний сторонньому ШІ
Друга частина анонсу стосується Search API та Fetch API. За документацією, пошук працює на власному рушії DeepSeek, який щодня обробляє сотні мільйонів запитів і індексує сотні мільярдів сторінок. Компанія стверджує, що рушій відсіює SEO-спам, маніпуляції з GEO та низькоякісний ШІ-контент.
Search API повертає до 50 ранжованих результатів на запит, а Fetch перетворює окрему вебсторінку на Markdown. Інструкції з підключення є в гайді DeepSeek.
Умови такі:
- Ціна: $0,75 за 1000 викликів кожного з двох API.
- Безплатний період: користувачі DeepSeek API можуть безкоштовно користуватися пошуковими інструментами через серверні інтеграції в DeepSeek Harness, Claude Code і Codex до 31 жовтня 2026 року, 16:00 за UTC.
Нагадаємо, не так давно стало відомо, що китайська LLM-модель DeepSeek-R1 генерує небезпечний код, якщо в запитах згадується Тибет або уйгури.
Джерело: highload.tech