
Alibaba продовжує тиснути на ринок опенсорсного штучного інтелекту: команда Qwen випустила Qwen-Image-2.1 — модель для генерації та редагування зображень з відкритими вагами, яка, за словами розробників, обходить більшість закритих аналогів, маючи всього 7 мільярдів параметрів. Про реліз повідомляє The Decoder, а деталі архітектури розкриває офіційний блог Qwen.
Менше параметрів, більше можливостей
Головна теза релізу — модель не стала більшою, вона стала компактнішою. Візуальний генеративний компонент Qwen-Image-2.1 налічує лише 7 млрд параметрів (32 шари Single-Stream DiT) — це втричі менше, ніж 20 млрд у попередній версії Qwen-Image 1.0. При цьому модель об’єднує в одному пайплайні одразу кілька функцій:
- генерацію зображень за текстовим промптом;
- редагування наявних зображень;
- нативну підтримку прозорих зображень у форматі RGBA — модель може як генерувати графіку з прозорим фоном, так і виділяти об’єкт із фотографії на окремий прозорий шар;
- роботу одразу з десятьма референсними зображеннями — для групових портретів, віртуальної примірки одягу чи дизайну інтер’єру;
- локальне редагування за допомогою кіл, масок або намальованих від руки позначок.
Модель також підтримує нативну генерацію у роздільній здатності 2K і, за словами розробників, покращену типографіку та світлотіні в портретах.
Швидкість за рахунок архітектурних хитрощів
За прискорення інференсу, особливо при роботі з кількома референсними зображеннями одночасно, відповідає змішана гранулярність уваги (mixed-granularity attention) у поєднанні з повторним використанням KV-кешу префіксу. Простими словами: текстові інструкції та вхідні зображення обчислюються й кешуються один раз на першому кроці, а не перераховуються заново на кожному наступному — це суттєво зменшує навантаження при мультиреференсному редагуванні.
Завдяки такій оптимізації модель здатна працювати навіть на відносно потужних споживчих відеокартах — розробники наводять як приклад GeForce RTX 3090.
Місце в рейтингу: сьома з 29, але перша серед відкритих
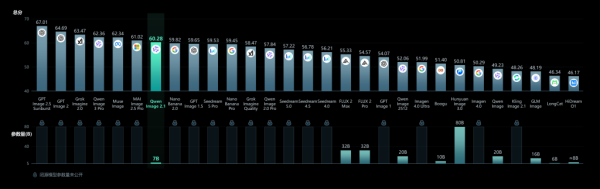
За внутрішнім бенчмарком Qwen-Image-Bench модель отримала загальний бал 60,28 — це сьоме місце з 29 протестованих моделей. Попереду неї — шість закритих рішень, лідирує GPT Image 2.5 Sunburst із результатом 67,01. При цьому Qwen-Image-2.1 випередила Nano Banana 2.0 (59,82) і залишила позаду абсолютно всі відкриті моделі в списку, включно з набагато більшою FLUX 2 Max на 32 млрд параметрів.
Варто зауважити: бенчмарк — власний і поки що не підтверджений незалежними тестами, а кількість параметрів закритих конкурентів невідома, тому коректно порівнювати розмір моделі можна лише серед відкритих рішень.
Доступ є, але з застереженням щодо ліцензії
Модель уже доступна на Hugging Face, GitHub і Model Scope, там-таки є демоверсія для тестування. Проте ліцензія моделі — дослідницька і прямо забороняє комерційне використання: компаніям, які захочуть застосувати Qwen-Image-2.1 у бізнесі, доведеться окремо звертатися до Qwen за комерційною ліцензією.
Що обговорює Hacker News
Обговорення на HN зібрало десятки коментарів, і найгарячіша тема — саме ліцензія. Користувач jfoster звернув увагу, що попередні моделі Qwen зазвичай виходили під ліцензією Apache, тоді як нова версія має значно жорсткіші умови використання.
Коментатор gregoriol підтвердив тенденцію: останні опенсорсні моделі для генерації зображень з ліцензією Apache 2.0 виходили ще у 2025-му, а тепер у Qwen «некомерційне використання» стало нормою. Користувач jfoster додав ще одну деталь із самого тексту ліцензії: використання матеріалів у комерційних цілях без окремої ліцензії прямо заборонене, тож зрештою вартість використання моделі залежатиме від рішень Alibaba, а не просто від витрат на хмарну інфраструктуру.
Дехто пішов ще далі в критиці: юзер gunalx зауважив, що нова відкрита модель навіть не перевершує власну закриту Qwen3 Image від тієї ж компанії, яка вже встигла застаріти.
Утім, загальний настрій спільноти лишається доброзичливим. Коментатор d2kx назвав команду Qwen «найрізноманітнішою» серед усіх китайських лабораторій — за його словами, з нею може позмагатися хіба що Gemini/DeepMind. А користувач hgufj прямо подякував китайським лабораторіям за відкритість моделей: «Якби це залежало від американців, нам довелося б платити шалені гроші за доступ через API».
Технічна частина дискусії зосередилась навколо запуску моделі локально — користувачі обговорювали варіанти через ComfyUI, vLLM, SGLang та diffusion.cpp, оскільки стандартний llama.cpp поки що не підтримує генерацію зображень напряму. Один із коментаторів (trains39472) із захопленням зауважив, що 7-мільярдна дифузійна модель тепер рендерить китайські, японські й корейські ієрогліфи краще, ніж це робить сама Windows.
Були й скептичні голоси: користувач BlackGlory натякнув на характерний жовтуватий відтінок згенерованих зображень — так званий «piss filter», який асоціюють із ChatGPT, натякаючи, що модель могла бути дистильована із зображень, згенерованих конкурентом. Втім, це припущення так і лишилося без доказів. Інший коментатор (trentor) відзначив протилежне — на його думку, у Qwen нарешті «полагодили VAE», який роками стримував якість зображень у попередніх версіях моделі.
Нагадаємо, під час експерименту локальна модель Qwen 3.5-9B впоралася з 95% робочих задач розробника.